Preview
流表入门
Event 事件
记录某件事发生的事实,结构如下
key:Alice
value:has arrived in room
timestamp:Dec.3, 2019 at 9:06 a.m.
Stream 流
记录event的历史,是一个有序的event序列,流表示过去和现在,新事件会不断追加到历史中
Table表
表表示某一时刻的状态,通常是当前状态,表是流的一个视图,会随着新事件的捕获不断更新
流与表的区别
流:数据不可变,仅支持插入,不改变现有事件,类似于关系数据库中没有唯一键约束且仅支持追加操作的表。
表:数据可变,支持插入,更新和删除,类似于关系数据库中的物化视图,会随着输入流或表的变化而自动更新。
流表二元性
流转表
通过对流聚合操作(count()或sum()),可以将流转换为表
表转流
捕获表的变更(插入,更新和删除),可以将表转换为变更流。
流表二元性意义
流和表可以相互转换,这种二元性是kafka的核心特性之一。
类似于关系数据库中的重做日志或二进制日志。
为什么需要kafka streams
简化开发和部署:不需要额外的流处理集群,降低运维复杂性
低延迟实时处理:支持逐事件处理,满足毫秒级别延迟需求
有状态处理:具有内置的状态存储,允许应用程序在本地维护状态
流与表无缝集成:具有流表二元性,可以相互转换
分布式处理和容错性:利用kafka的分布式特性,支持快速故障转移和负载均衡,在多个实例之间动态分配处理任务,确保高可用和容错
无停机滚动部署:升级应用程序或扩展处理能力可以不停机
适用于核心业务应用程序:传统流处理框架更适合用于分析任务,而不适合用于构建核心业务应用程序,而kafka streams专注于构建核心业务应用程序和其他系统,增加了复杂性
kafka Stream的集成优势:传统系统需要手动集成,而kafka直接构建在kafka的核心抽象之上,可以无缝集成。
无框架流处理
无框架设计:Kafka Streams 是一个嵌入式库,无需额外的流处理集群。
负载均衡:自动分配和重新平衡处理负载。
本地状态管理:支持在本地维护状态,并在需要时重新创建。
故障恢复:利用 Kafka 的容错机制,确保快速恢复。
无停机部署:支持滚动升级和扩展,确保业务连续性。
与容器化技术集成:可以与 Kubernetes、Mesos 等现代容器编排框架无缝集成。
流表集成简化处理应用程序
流表介绍可以参考第一节
流表操作
连接和聚合,结果也是表
窗口化操作
状态化操作
通过本地嵌入式键值存储(RocksDB)来维护表的状态
这种设计使得应用程序可以直接查询本地计算的状态,从而实现状态化服务
本地化服务优势
对于频繁访问大量数据的应用程序,本地状态存储可以提供极高的性能
窗口化操作
窗口化操作是一个子集概念,窗口是数据流的一个子集
1. 窗口化操作的核心概念
1.1 窗口(Window)
- 定义:窗口是数据流的一个有限子集,通常基于时间或数量进行划分。
- 类型:
- 时间窗口(Time Window):基于时间划分窗口,如每5分钟、每小时等。
- 计数窗口(Count Window):基于事件数量划分窗口,如每100个事件。
- 会话窗口(Session Window):基于事件之间的时间间隔划分窗口,适用于用户行为分析。
1.2 窗口化操作的作用
- 聚合计算:对窗口内的数据进行聚合操作,如求和、平均值、最大值等。
- 统计分析:计算窗口内的统计指标,如点击率、转化率等。
- 事件处理:对窗口内的事件进行特定处理,如检测异常、触发告警等。
2. 窗口化操作的挑战
2.1 乱序数据(Out-of-Order Data)
- 问题:在分布式系统中,事件可能因为网络延迟或其他原因乱序到达。
- 解决方案:
- 事件时间(Event Time):使用事件的实际发生时间(而非到达时间)进行窗口划分。
- 水位线(Watermark):通过水位线机制处理乱序数据,确定窗口的关闭时间。
2.2 窗口的完整性
- 问题:如何确定一个窗口内的所有事件都已到达?
- 解决方案:
- 延迟处理:允许窗口延迟关闭,等待可能迟到的数据。
- 增量更新:窗口内的计算结果可以随着新数据的到达不断更新。
3. Kafka Streams 中的窗口化操作
Kafka Streams 提供了强大的窗口化操作支持,能够处理乱序数据并实现增量更新。
3.1 时间窗口
- 滚动窗口(Tumbling Window):
- 窗口之间没有重叠,每个事件只属于一个窗口。
- 示例:每5分钟计算一次销售额。
- 滑动窗口(Sliding Window):
- 窗口之间有重叠,一个事件可能属于多个窗口。
- 示例:每1分钟计算过去5分钟的销售额。
- 会话窗口(Session Window):
- 基于事件之间的时间间隔划分窗口,适用于用户行为分析。
- 示例:用户在一次会话内的点击行为。
3.2 窗口化操作的实现
- 增量聚合:
- Kafka Streams 支持增量聚合,窗口内的计算结果会随着新数据的到达不断更新。
- 示例:计算每5分钟的销售额,结果会随着新销售数据的到达不断更新。
- 乱序数据处理:
- Kafka Streams 使用事件时间和水位线机制处理乱序数据,确保窗口计算的准确性。
4. 窗口化操作的应用场景
4.1 实时监控
- 场景:监控系统的实时指标,如CPU使用率、网络流量等。
- 操作:每1分钟计算过去5分钟的平均值。
4.2 用户行为分析
- 场景:分析用户在网站或应用中的行为。
- 操作:计算用户在一次会话内的点击次数、停留时间等。
4.3 实时风控
- 场景:检测异常交易或行为。
- 操作:每10分钟计算过去1小时内的交易次数,检测异常交易。
5. 示例:Kafka Streams 中的窗口化操作
以下是一个简单的 Kafka Streams 示例,计算每5分钟的销售额:
java
复制
import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.kstream.*;

import java.time.Duration;
import java.util.Properties;

public class WindowedSalesApp {
    public static void main(String[] args) {
        // 配置 Kafka Streams
        Properties props = new Properties();
        props.put("application.id", "windowed-sales-app");
        props.put("bootstrap.servers", "localhost:9092");
        props.put("default.key.serde", Serdes.String().getClass().getName());
        props.put("default.value.serde", Serdes.String().getClass().getName());

        // 定义流处理拓扑
        StreamsBuilder builder = new StreamsBuilder();
        KStream<String, String> salesStream = builder.stream("sales-topic");

        // 定义时间窗口(每5分钟)
        TimeWindows window = TimeWindows.of(Duration.ofMinutes(5));

        // 计算每5分钟的销售额
        KTable<Windowed<String>, Long> salesPerWindow = salesStream
            .groupByKey()
            .windowedBy(window)
            .count();

        // 输出结果到 Kafka 主题
        salesPerWindow.toStream()
            .to("sales-per-window-topic", Produced.with(WindowedSerdes.timeWindowedSerdeFrom(String.class), Serdes.Long()));

        // 启动 Kafka Streams 应用程序
        KafkaStreams streams = new KafkaStreams(builder.build(), props);
        streams.start();

        // 添加关闭钩子
        Runtime.getRuntime().addShutdownHook(new Thread(streams::close));
    }
}
总结
窗口化操作是流处理中的核心功能,用于对无界数据流进行分段处理。Kafka Streams 提供了强大的窗口化操作支持,能够处理乱序数据并实现增量更新。通过窗口化操作,开发者可以轻松实现实时监控、用户行为分析、实时风控等应用场景。
关键点总结
应用场景:实时监控、用户行为分析、实时风控等。
窗口类型:时间窗口(滚动窗口、滑动窗口)、计数窗口、会话窗口。
乱序数据处理:使用事件时间和水位线机制。
增量聚合:窗口内的计算结果会随着新数据的到达不断更新。
简化流处理应用程序的构建与运维
1. 传统流处理架构的复杂性
- 传统架构的复杂性:
- 典型的流处理应用程序架构通常包含许多复杂的组件:
- Kafka 本身。
- 流处理集群(如 Storm 或 Spark),通常包括主进程和节点守护进程。
- 实际的流处理任务。
- 用于查找和聚合的辅助数据库。
- 用于存储流处理结果并供应用程序查询的输出数据库。
- Hadoop 集群(本身包含许多组件),用于数据重处理。
- 处理用户请求的请求/响应应用程序。
- 这种架构不仅复杂,而且难以运维和监控。
- 典型的流处理应用程序架构通常包含许多复杂的组件:
2. Kafka Streams 的简化设计
Kafka Streams 通过以下方式简化了流处理应用程序的构建和运维:
2.1 无外部集群
- Kafka Streams 是一个嵌入式库,无需额外的流处理集群。
- 开发者只需将 Kafka Streams 库嵌入应用程序中,即可利用 Kafka 的分布式和容错特性。
2.2 流与表的集成
- Kafka Streams 将流(stream)和表(table)的概念集成到一个统一的框架中,支持流表二元性。
- 这种设计简化了复杂的数据处理逻辑,如聚合、连接和窗口化操作。
2.3 与 Kafka 生态系统的无缝集成
- Kafka Streams 直接构建在 Kafka 的核心抽象之上,与 Kafka 生态系统无缝集成。
- 输入和输出都是 Kafka 主题,数据模型和分区模型与 Kafka 一致。
3. Kafka Streams 的优势
- 简洁的代码:Kafka Streams 的代码库非常小(不到 9000 行代码),易于理解和扩展。
- 统一的监控:Kafka Streams 的指标与 Kafka 生产者和消费者统一,简化了监控和运维。
- 事件时间处理:Kafka Streams 支持事件时间(event-time)处理,能够处理乱序数据。
- 灵活的重处理:如果需要重新处理数据,只需回退 Kafka 偏移量即可,无需依赖其他系统(如 Hadoop)。
4. Kafka Streams 的应用场景
- 实时数据处理:如点击流分析、用户行为分析。
- 实时聚合:如计算每分钟的点击量、每小时的交易总额。
- 实时转换:如数据格式转换、字段提取。
- 实时连接:如流-流连接、流-表连接。
- 复杂事件处理(CEP):如异常检测、欺诈检测。
总结
Kafka Streams 通过无外部集群设计、流与表的集成和与 Kafka 生态系统的无缝集成,大幅简化了流处理应用程序的构建和运维。它使得流处理变得更加易于使用和运维,适用于实时数据处理、实时聚合、实时转换、实时连接和复杂事件处理等应用场景。
关键点总结
应用场景:实时数据处理、实时聚合、实时转换、实时连接、复杂事件处理。
传统架构的复杂性:传统流处理架构包含许多复杂组件,难以运维和监控。
Kafka Streams 的简化设计:
无外部集群,嵌入式库设计。
流与表的集成,支持流表二元性。
与 Kafka 生态系统的无缝集成。
Kafka Streams 的优势:
简洁的代码,易于理解和扩展。
统一的监控,简化运维。
事件时间处理,支持乱序数据。
灵活的重处理,无需依赖其他系统。
Concepts
Kafka 101
谁是谁
生产者 producer
消费者 consumer
代理人 broker
生产者向Kafka代理发布数据,消费者从Kafka代理读取发布的数据。生产者和消费者完全解耦,都在Kafka集群外围的Kafka代理之外运行。Kafka集群由一个或多个代理组成。使用Kafka Streams API的应用程序同时充当生产者和消费者。
数据
数据都存储在topic中,每个topic有不同的partition(分区)
并行性
Kafka主题的分区,特别是给定主题的分区数量,也是决定Kafka读写数据并行性的主要因素。由于与Kafka紧密集成,使用Kafka Streams API的应用程序的并行性主要取决于Kafka的并行性。
Stream
流是Kafka Streams提供的最重要的抽象:它表示一个无界的、不断更新的数据集,其中无界意味着“未知或无限大小”。就像Kafka中的主题一样,Kafka Streams API中的流由一个或多个流分区组成。
流分区是一个有序、可重放和容错的不可变数据记录序列,其中数据记录被定义为键值对。
Stream Processing Application
流处理应用程序运行在单独的jvm实例中,而不是在集群中。
Stream Topology 和 Stream Processor
流拓扑和流处理器,流处理器作为流拓扑的一个节点,作为处理数据的一个步骤
Stateful Stream Processing
状态流处理
一些流处理应用程序不需要状态——它们是无状态的——这意味着消息的处理独立于其他消息的处理。例如,一次只需要转换一条消息,或者根据某些条件过滤掉消息。
然而,在实践中,大多数应用程序都需要状态(它们是有状态的)才能正常工作,并且必须以容错方式管理这种状态。例如,每当应用程序需要连接、聚合或窗口化其输入数据时,它都是有状态的。Kafka Streams为您的应用程序提供了强大、灵活、高度可扩展和容错的有状态处理功能。
Duality of Streams and Tables
流即表:流可以被视为表的更改日志,流中的每个数据记录都捕获了表的状态更改。因此,流是一个伪装的表,通过从头到尾重放更改日志来重建表,它可以很容易地变成一个“真实”的表。同样,聚合流中的数据记录将返回一个表。例如,我们可以根据页面浏览事件的输入流计算用户的页面浏览总数,结果将是一个表,表键是用户,值是相应的页面浏览计数。
表即流:表可以被视为流中每个键在某个时间点的最新值的快照(流的数据记录是键值对)。因此,表是伪装的流,通过迭代表中的每个键值条目,可以很容易地将其转换为“真实”流。
KStream
KStream是记录流的抽象,其中每个数据记录表示无界数据集中的自包含数据。使用表类比,记录流中的数据记录总是被解释为“INSERT”——想想:在只追加的分类账中添加更多条目——因为没有记录用相同的键替换现有的行。例如信用卡交易、页面查看事件或服务器日志条目。
只有Kafka Streams DSL具有KStream的概念。
KTable
KTable是变更日志流的抽象,其中每个数据记录代表一次更新。更确切地说,数据记录中的值被解释为同一记录键的最后一个值的“UPDATE”(如果有)(如果相应的键还不存在,则更新将被视为INSERT)。使用表类比,更改日志流中的数据记录被解释为UPSERT,即INSERT/UPDATE,因为任何具有相同键的现有行都会被覆盖。此外,空值以一种特殊的方式解释:具有空值的记录表示记录键的“DELETE”或墓碑。
Effect of Kafka log compaction
关于KStream和KTable的另一种思考方式如下:如果你要将KTable存储到Kafka主题中,你可能想启用Kafka的日志压缩功能来节省存储空间。
但是,在KStream的情况下启用日志压缩是不安全的,因为一旦日志压缩开始清除相同密钥的旧数据记录,就会破坏数据的语义。再次拿起插图示例,你会突然得到alice的3,而不是4,因为日志压缩会删除(“alice”,1)数据记录。这意味着日志压缩对于KTable(changelog流)是安全的,但对于KStream(记录流)是错误的。
日志压缩对表安全,对流不安全
GlobalKTable
与KTable一样,GlobalKTable是变更日志流的抽象,其中每个数据记录代表一次更新。
GlobalKTable和KTable的区别在于填充的数据
KTable只会存储Topic中一个分区的数据
GlobalTable会存储所有分区的数据
全局表的好处:
您可以使用全局表将信息“广播”到应用程序的所有运行实例。
全局表实现了更方便、更高效的连接。
全局表支持星型连接。
当链接多个联接时,全局表的效率更高。
当对全局表进行联接时,输入数据不需要进行共分区。
全局表支持“外键”查找,这意味着您不仅可以按记录键,还可以按记录值中的数据查找表中的数据。在这种情况下,连接总是使用表的主键,“外键”指的是流记录。与始终根据流记录键计算连接的流表连接不同,流globalKTable连接使您能够直接从流记录的值中提取连接键。
全局表的缺点包括:
与(分区的)KTable相比,本地存储消耗增加,因为整个主题都被跟踪。
与(分区的)KTable相比,网络和Kafka代理负载增加,因为整个主题都被读取。
Time
流处理中的一个关键方面是时间的概念,以及如何对其进行建模和集成。例如,某些操作(如窗口化)是基于时间边界定义的。
1. 事件时间(Event Time)
- 定义:事件实际发生的时间,通常由数据源生成时嵌入到记录中。
- 示例:GPS传感器记录的位置变化时间。
- 特点:事件时间通常是最准确的时间语义,但需要数据源支持时间戳的嵌入。
2. 处理时间(Processing Time)
- 定义:流处理应用程序处理记录的时间。
- 示例:分析应用程序处理GPS数据的时间。
- 特点:处理时间通常比事件时间晚,可能延迟几毫秒到几小时甚至几天,具体取决于处理管道的类型(实时或批处理)。
3. 摄取时间(Ingestion Time)
- 定义:Kafka代理将记录存储到主题分区中的时间。
- 特点:摄取时间近似于事件时间,但时间戳是在记录进入Kafka时生成的。适用于无法使用事件时间的场景(如旧版Kafka生产者或无法访问本地时钟的情况)。
4. 流时间(Stream Time)
- 定义:到目前为止,所有已处理记录中最大的时间戳。
- 特点:Kafka Streams 在每个任务的基础上跟踪流时间,用于同步多个输入流。
5. 时间戳提取器(Timestamp Extractor)
- 定义:Kafka Streams 通过时间戳提取器为每条记录分配时间戳。
- 用途:时间戳提取器可以根据记录内容提取时间戳,支持事件时间、摄取时间或处理时间语义。
- 示例:自定义时间戳提取器可以从记录中提取时间戳,并将其用于处理时间或事件时间语义。
6. 输出记录的时间戳分配
- 继承输入记录时间戳:当输出记录直接由输入记录生成时,时间戳通常从输入记录继承。
- 周期性函数生成的时间戳:输出记录的时间戳定义为流任务的当前内部时间。
- 聚合和连接操作的时间戳:
- 对于连接操作,输出记录的时间戳为左右输入记录时间戳的最大值。
- 对于流表连接,输出记录的时间戳为流记录的时间戳。
- 对于聚合操作,时间戳为触发更新的最新输入记录的时间戳。
7. 处理器API中的时间戳分配
- 显式分配时间戳:可以通过
forward()方法显式为输出记录分配时间戳。 - 示例:在
Processor实现中,可以从输入记录中提取时间戳,并通过自定义方法计算输出记录的时间戳。
8. Kafka Streams API中的时间戳分配
- 自定义时间戳提取器:通过实现
TimestampExtractor接口,可以从记录中提取时间戳,并将其用于处理时间或事件时间语义。 - 示例:自定义时间戳提取器可以从记录中提取时间戳,并在创建
KStream时使用该提取器。
9. 其他时间方面的注意事项
时间语义的一致性:避免将具有不同时间语义的主题混合在一起。
时区和日历:确保时区和日历在整个流数据管道中正确同步,或至少理解和跟踪这些差异。
时间格式:通常建议使用UTC或Unix时间(如纪元后的秒数)来指定时间信息,以避免时区混淆。
Aggregations Joins Windowing
聚合(Aggregations)
定义:聚合操作接收一个输入流或表,并通过将多个输入记录组合成单个输出记录来生成一个新的表。常见的聚合操作包括计算计数或求和。
特点:
- 在 Kafka Streams DSL 中,聚合操作的输入可以是
KStream或KTable,但输出始终是KTable。 - 这种设计允许 Kafka Streams 在记录乱序到达时更新聚合值。当乱序记录到达时,聚合操作会生成并发出一个新的聚合值。
- 由于输出是
KTable,新值会覆盖旧值(相同键),并在后续处理步骤中使用。
适用场景:适用于需要基于键(key)对记录进行分组并计算聚合结果的场景,如计算总和、平均值或计数。
连接(Joins)
定义:连接操作基于数据记录的键(key)合并两个输入流或表,并生成一个新的流或表。
特点:
- Kafka Streams DSL 提供了多种连接操作,具体取决于被连接的流和表的类型。例如,
KStream-KStream连接、KStream-KTable连接等。 - 连接操作通常用于将两个数据集基于键进行关联,例如将用户行为数据与用户属性数据关联。
适用场景:适用于需要将两个数据集基于键进行合并的场景,如数据关联、数据补充等。
窗口化(Windowing)
定义:窗口化操作允许你将具有相同键的记录分组到称为“窗口”的时间段中,以便进行有状态操作(如聚合或连接)。窗口是基于每个记录键进行跟踪的。
特点:
- 在 Kafka Streams DSL 中,窗口化操作可以指定一个宽限期(grace period),用于控制窗口结果的最终性。宽限期决定了 Kafka Streams 会等待乱序记录多长时间。
- 如果记录在窗口的宽限期之后到达(即
record.ts > window-end-time + grace-period),则该记录将被丢弃,不会在该窗口中进行处理。 - 乱序记录在现实世界中是常见的,应用程序需要正确处理它们。Kafka Streams 能够为事件时间语义(event-time)正确处理乱序记录。
宽限期与保留时间:
- 宽限期(grace period)是窗口结束后允许乱序事件到达的时间,直接关系到窗口结果的最终性。
- 保留时间(retention time)是窗口存储的低级属性,用于控制事件在存储中保留的时间。宽限期是保留时间的下限。
适用场景:适用于基于时间窗口的聚合或连接操作,如计算每分钟的点击量、每小时的交易总额等。
总结
- 聚合:
- 将多个输入记录组合成单个输出记录,输出始终是
KTable。 - 支持乱序记录的更新,适用于计数、求和等操作。
- 将多个输入记录组合成单个输出记录,输出始终是
- 连接:
- 基于键合并两个输入流或表,生成新的流或表。
- 适用于数据关联和数据补充场景。
- 窗口化:
- 将记录按时间窗口分组,支持有状态操作(如聚合或连接)。
- 通过宽限期控制乱序记录的处理,适用于基于时间窗口的计算。
核心要点:
- Kafka Streams 提供了强大的时间处理能力,支持事件时间、处理时间和摄取时间语义。
- 乱序记录的处理是流处理中的关键问题,Kafka Streams 通过窗口化和宽限期机制有效解决了这一问题。
- 聚合、连接和窗口化是 Kafka Streams 中最常用的有状态操作,适用于复杂的流处理场景。
Interactive Queries
交互式查询(Interactive Queries)
定义:交互式查询允许你将流处理层视为一个轻量级的嵌入式数据库,并直接查询流处理应用程序的最新状态。你无需先将状态物化到外部数据库或存储系统中。
特点:
- 交互式查询简化了架构,使其更加以应用程序为中心。
- 它提供了灵活性,允许你根据具体用例选择最合适的架构,而不是局限于单一的方式。
- 你还可以运行混合架构,例如应用程序可以支持交互式查询,同时将部分结果共享给外部系统(如通过 Kafka Connect)。
架构对比:
- 不使用交互式查询:
- 架构复杂性增加,需要依赖外部数据库或存储系统。
- 状态需要先物化到外部系统,增加了延迟和资源开销。
- 使用交互式查询:
- 架构简化,更加以应用程序为中心。
- 可以直接查询流处理应用程序的状态,减少了对外部系统的依赖。
适用场景
以下是一些受益于交互式查询的应用场景示例:
- 实时监控:
- 前端仪表板可以实时查询 Kafka Streams 应用程序,获取当前受网络攻击的服务器信息。
- 示例:基于实时网络遥测数据生成威胁情报。
- 视频游戏:
- Kafka Streams 应用程序持续跟踪玩家在游戏世界中的位置更新。
- 移动伴侣应用可以直接查询玩家的当前位置,并邀请朋友加入。
- 游戏厂商可以利用数据识别玩家异常聚集的热点,发现潜在的游戏漏洞或操作问题。
- 风险与欺诈检测:
- Kafka Streams 应用程序持续分析用户交易,检测异常和可疑行为。
- 在线银行应用可以在用户登录时直接查询 Kafka Streams 应用程序,拒绝标记为可疑的用户访问。
- 趋势检测:
- Kafka Streams 应用程序基于实时收集的用户听歌行为,持续计算最新的音乐排行榜。
- 音乐商店的移动或桌面应用可以在用户浏览时交互式查询最新排行榜。
总结
- 核心优势:
- 交互式查询将流处理层变为一个轻量级嵌入式数据库,支持直接查询应用程序的最新状态。
- 简化了架构,减少了对外部系统的依赖,降低了复杂性和资源开销。
- 适用场景:
- 实时监控、视频游戏、风险与欺诈检测、趋势检测等需要实时查询和响应状态的场景。
- 灵活性:
- 支持纯交互式查询架构,也支持混合架构(如与外部系统共享部分结果)。
- 开发者价值:
- 提供了更高效、更灵活的流处理解决方案,适用于需要低延迟和高实时性的应用场景。
通过交互式查询,Kafka Streams 不仅能够处理实时数据流,还能直接提供查询服务,极大地提升了流处理应用程序的实用性和灵活性。
Processing Guarantees
处理保证(Processing Guarantees)
Kafka Streams 支持 至少一次(at-least-once) 和 精确一次(exactly-once) 的处理保证。
1. 至少一次语义(At-least-once Semantics)
定义:记录不会丢失,但可能会被重新传递和处理。如果流处理应用程序失败,数据记录不会丢失,但某些记录可能会被重新读取并重新处理。
特点:
- 默认情况下,Kafka Streams 启用至少一次语义(
processing.guarantee="at_least_once")。 - 适用于对数据重复不敏感的场景,但可能会导致重复处理。
问题:
- 如果消息成功写入状态存储但未能成功写入输出主题,或者消息成功写入输出主题但未能提交,可能会导致数据不一致(如重复记录或数据丢失)。
2. 精确一次语义(Exactly-once Semantics)
定义:记录只会被处理一次。即使生产者发送了重复记录,它也会被精确地写入一次。精确一次流处理确保 读取-处理-写入 操作只执行一次。
特点:
- 通过设置
processing.guarantee="exactly_once_v2"启用精确一次语义。 - 生产者配置为幂等写入,确保重试不会导致重复记录。
- 多个记录被分组到单个事务中,要么全部提交,要么全部回滚。
实现机制:
- 事务性写入:写入操作在确认成功后才被视为完成,提交操作用于“最终化”写入。
- 消费者位置管理:消费者的位置(offset)作为记录存储在主题中。在精确一次语义下,单个事务会同时写入偏移量和处理后的数据到输出主题。
- 隔离级别:
read_uncommitted(默认):消费者可以看到所有记录,包括未提交的事务记录。read_committed:消费者只能看到已提交事务的记录。
适用场景:
- 适用于对数据一致性要求极高的场景,如金融交易、欺诈检测等。
状态操作中的精确一次语义
问题:
- 在至少一次语义下,状态存储持久化、数据生产和提交操作是独立且异步的,可能会导致状态不一致。
- 例如,去重应用程序可能会存储消息但未能将其写入输出主题,重新处理时可能会跳过重复消息,导致数据丢失。
解决方案:
- 使用精确一次语义,将状态存储持久化、数据生产和提交操作耦合在同一个事务中,确保在重新处理时状态的一致性。
总结
- 至少一次语义:
- 记录不会丢失,但可能会重复处理。
- 适用于对数据重复不敏感的场景。
- 默认启用,配置为
processing.guarantee="at_least_once"。
- 精确一次语义:
- 记录只会被处理一次,确保数据一致性。
- 通过事务性写入和幂等生产者实现。
- 配置为
processing.guarantee="exactly_once_v2"。 - 适用于对数据一致性要求极高的场景。
- 状态操作中的精确一次语义:
- 在状态操作中,精确一次语义可以避免状态不一致问题。
- 通过将状态存储持久化、数据生产和提交操作耦合在同一个事务中实现。
- 注意事项:
- 在启用精确一次语义时,Confluent Monitoring Interceptors 无法与 Confluent Control Center 一起配置。
核心价值:
- Kafka Streams 提供了灵活的处理保证机制,开发者可以根据业务需求选择至少一次或精确一次语义。
- 精确一次语义通过事务性写入和幂等生产者,确保了数据处理的强一致性,适用于对数据准确性要求极高的场景。
Out-of-Order-Handling
乱序数据处理(Out-of-Order Handling)
在流处理中,乱序数据是一个常见的挑战,可能会影响业务逻辑的正确性。Kafka Streams 提供了机制来处理乱序数据,以下是相关内容的总结:
1. 乱序数据的原因
在 Kafka Streams 中,乱序数据可能由以下两种原因导致:
- 分区内的乱序:
- 在同一个主题分区中,记录的时间戳可能不会随偏移量(offset)单调递增。
- Kafka Streams 按照偏移量顺序处理记录,因此可能会导致时间戳较大的记录(但偏移量较小)先于时间戳较小的记录(但偏移量较大)被处理。
- 多分区处理的乱序:
- 如果一个流任务处理多个主题分区,并且应用程序未配置为等待所有分区都有缓冲数据,则可能会从时间戳最小的分区中选取记录进行处理。
- 这可能导致从其他分区获取的记录时间戳比已处理的记录更小,从而使得较旧的记录在较新的记录之后被处理。
2. 乱序数据的影响
- 无状态操作:
- 乱序数据不会影响处理逻辑,因为无状态操作每次只考虑一条记录,不依赖于历史记录。
- 有状态操作:
- 对于聚合(aggregations)和连接(joins)等有状态操作,乱序数据可能导致处理逻辑错误。
- 为了处理乱序数据,通常需要让应用程序等待更长时间,并在等待期间维护状态,这需要在延迟、成本和正确性之间做出权衡。
3. 乱序数据的处理机制
- 窗口化操作:
- 在 Kafka Streams 中,可以通过配置窗口化操作(如窗口聚合)来处理乱序数据。
- 窗口化操作可以设置宽限期(grace period),允许在窗口关闭后一段时间内处理乱序数据。
- 如果记录在宽限期之后到达(即
record.ts > window-end-time + grace-period),则被视为“迟到记录”并被丢弃。 - 术语定义:
- 顺序(Order):在 Kafka Streams 中,默认指“时间戳顺序”(timestamp order),而不是偏移量顺序(offset order)。
- 乱序(Out-of-order):记录的时间戳不按流时间单调递增。对于窗口化操作,处理乱序数据需要设置宽限期。
- 迟到记录(Late):在窗口关闭后到达的记录(即超过窗口结束时间加宽限期)。这些记录会被丢弃,但可能仍会被其他操作符处理。
4. 延迟度量
- 可以使用
record-lateness指标来测量任务的平均和最大延迟,以监控乱序数据的影响。
总结
- 乱序数据的原因:
- 分区内时间戳不单调递增。
- 多分区处理时未等待所有分区数据。
- 乱序数据的影响:
- 对无状态操作无影响。
- 对有状态操作(如聚合和连接)可能导致逻辑错误。
- 处理机制:
- 通过窗口化操作和宽限期处理乱序数据。
- 迟到记录会被丢弃,但可能被其他操作符处理。
- 术语定义:
- 顺序:默认指时间戳顺序。
- 乱序:记录时间戳不按流时间单调递增。
- 迟到记录:超过窗口关闭时间加宽限期的记录。
- 监控:
- 使用
record-lateness指标监控延迟。
核心价值:
- Kafka Streams 提供了灵活的机制来处理乱序数据,特别是在有状态操作中。
- 通过窗口化操作和宽限期,可以在延迟、成本和正确性之间找到平衡,确保业务逻辑的正确性。
Architecture
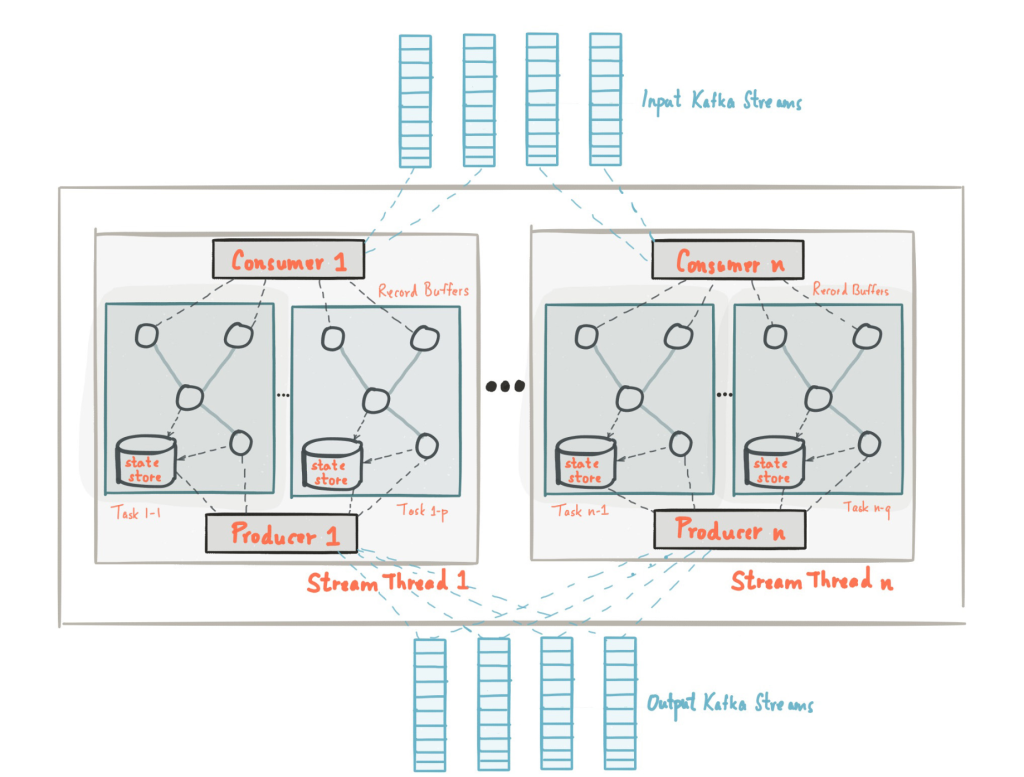
kafka生产消费架构
Processor Topology
处理器拓扑(Processor Topology)
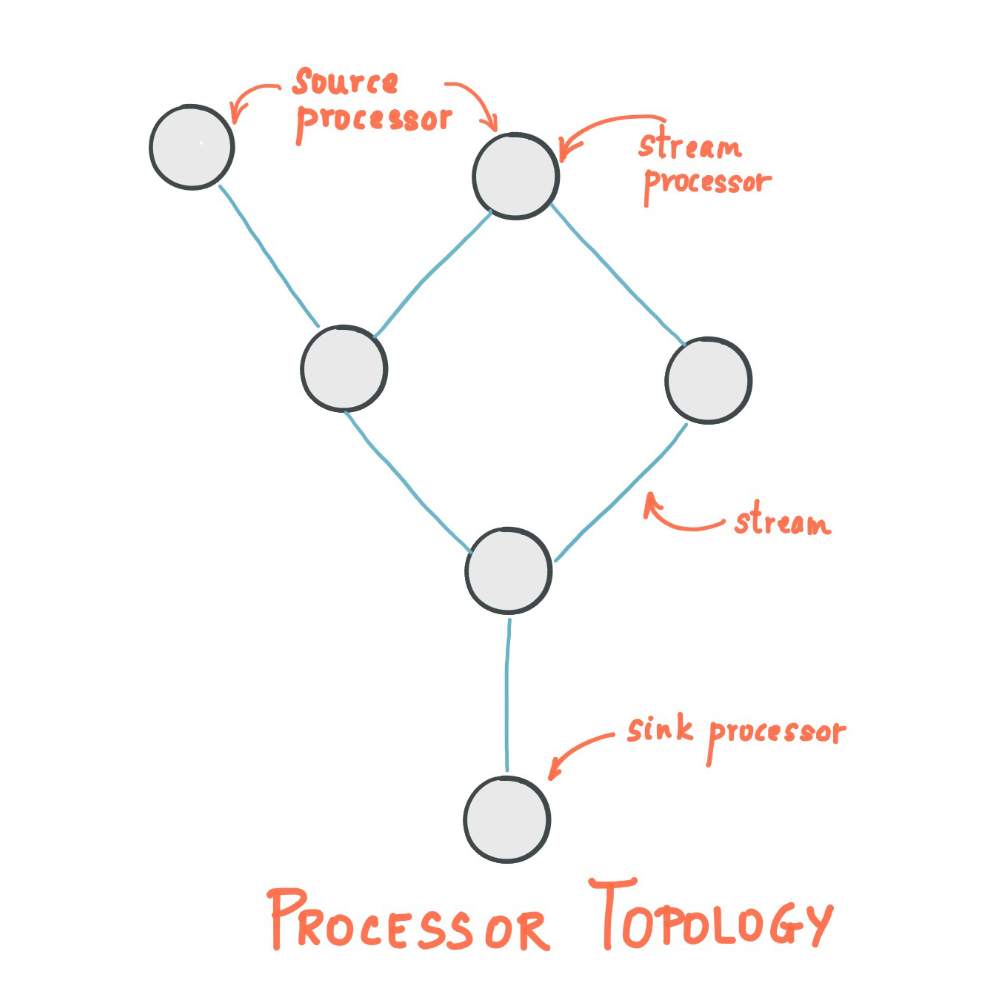
定义:处理器拓扑(或简称拓扑)定义了流处理应用程序的计算逻辑,即如何将输入数据转换为输出数据。拓扑是由流处理器(节点)和流(边)或共享状态存储组成的图。
1. 拓扑的组成
拓扑由以下核心组件构成:
- 流处理器(Stream Processor):
- 拓扑中的节点,负责处理数据。
- 每个流处理器可以执行无状态操作(如映射、过滤)或有状态操作(如聚合、连接)。
- 流(Stream):
- 拓扑中的边,表示数据在处理器之间的流动。
- 流是 Kafka 主题中记录的抽象表示。
- 共享状态存储(State Store):
- 用于存储有状态操作的中间结果。
- 状态存储可以是本地的(内存或磁盘)或持久化的(如 Kafka 或外部数据库)。
2. 特殊处理器
拓扑中有两种特殊的处理器:
- 源处理器(Source Processor):
- 一种没有上游处理器的特殊流处理器。
- 从 Kafka 主题中消费记录,并将其作为输入流传递给下游处理器。
- 示例:从 Kafka 主题
input-topic中读取数据并传递给下游的映射处理器。
- ** sink 处理器(Sink Processor)**:
- 一种没有下游处理器的特殊流处理器。
- 将接收到的记录发送到指定的 Kafka 主题。
- 示例:将处理后的记录写入 Kafka 主题
output-topic。
3. 拓扑的构建
流处理应用程序可以定义一个或多个拓扑,但通常只定义一个。开发者可以通过以下两种方式定义拓扑:
- 低级 Processor API:
- 提供更细粒度的控制,允许开发者自定义处理逻辑。
- 适用于需要高度定制化的场景。
- Kafka Streams DSL:
- 基于 Processor API 构建,提供更高级的抽象和易用性。
- 适用于大多数常见流处理场景。
4. 拓扑的示例
以下是一个简单的拓扑示例:
- 源处理器:从 Kafka 主题
input-topic中读取数据。 - 映射处理器:将每条记录的值转换为大写。
- 过滤处理器:过滤掉值为空的记录。
- Sink 处理器:将处理后的记录写入 Kafka 主题
output-topic。
用 Kafka Streams DSL 实现的伪代码:java复制KStream<String, String> stream = builder.stream("input-topic");
stream.mapValues(value -> value.toUpperCase())
.filter((key, value) -> !value.isEmpty())
.to("output-topic");
总结
- 拓扑的作用:
- 定义流处理应用程序的计算逻辑,描述数据如何从输入转换为输出。
- 核心组件:
- 流处理器:执行数据处理逻辑。
- 流:表示数据在处理器之间的流动。
- 共享状态存储:存储有状态操作的中间结果。
- 特殊处理器:
- 源处理器:从 Kafka 主题中读取数据。
- Sink 处理器:将数据写入 Kafka 主题。
- 构建方式:
- Processor API:提供细粒度控制,适用于定制化场景。
- Kafka Streams DSL:提供高级抽象,适用于常见场景。
- 示例:
- 通过 Kafka Streams DSL 可以轻松构建一个包含映射、过滤和输出的拓扑。
核心价值:
- 处理器拓扑是 Kafka Streams 应用程序的核心,定义了数据处理的流程和逻辑。
- 通过合理设计拓扑,可以实现高效、灵活的流处理应用程序。
Parallelism Model
并行模型(Parallelism Model)
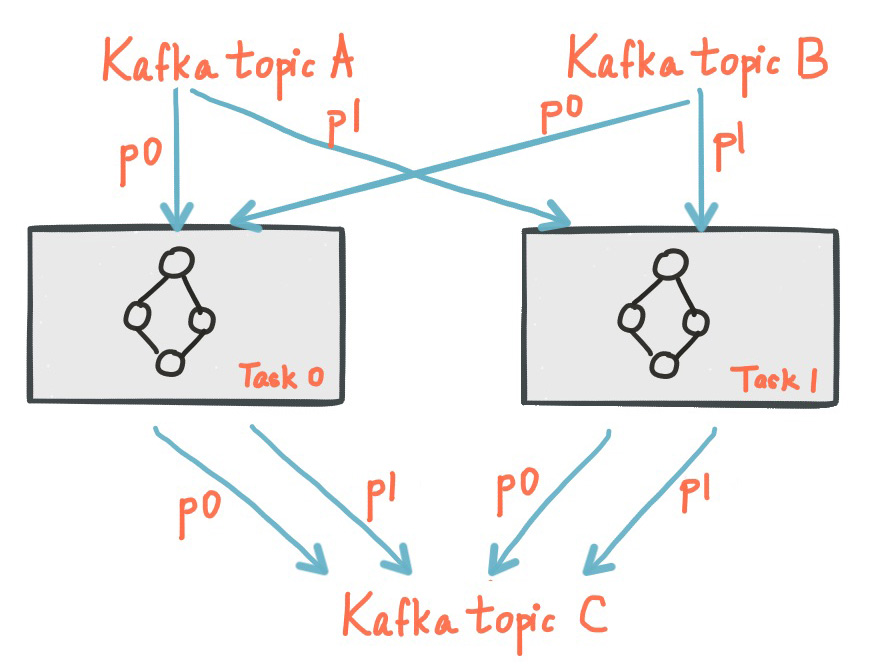
Kafka Streams 的并行模型基于 流分区(Stream Partitions) 和 流任务(Stream Tasks),这些概念与 Kafka 的分区模型紧密相关。以下是 Kafka Streams 并行模型的详细说明和总结。
1. 流分区与流任务
- 流分区(Stream Partitions):
- 每个流分区是一个完全有序的数据记录序列,对应 Kafka 主题的一个分区。
- 流中的数据记录对应 Kafka 主题中的消息。
- 数据记录的键(Key)决定了数据在 Kafka 和 Kafka Streams 中的分区方式,即数据如何路由到特定分区。
- 流任务(Stream Tasks):
- 流任务是 Kafka Streams 并行处理的基本单位。
- Kafka Streams 根据输入流的分区数量创建固定数量的流任务,每个任务分配一组输入流分区。
- 每个任务独立处理分配给它的分区,维护每个分区的缓冲区,并逐条处理记录。
- 流任务的分配是固定的,因此流任务是应用程序的固定并行单元。
并行度:
- 应用程序的最大并行度受限于输入主题的分区数量。
- 例如,如果输入主题有 5 个分区,则最多可以运行 5 个应用程序实例。如果运行更多实例,多余的实例将处于空闲状态,但可以在其他实例故障时接管工作。
2. 子拓扑(Sub-topologies)
- 如果 Kafka Streams 应用程序定义了多个处理器拓扑,每个任务只会实例化其中一个拓扑进行处理。
- 单个处理器拓扑可以分解为多个独立的子拓扑(或子图)。
- 子拓扑是一组通过父子关系或状态存储连接的处理器,不同子拓扑通过 Kafka 主题交换数据,不共享状态存储。
- 每个任务只能实例化一个子拓扑进行处理,从而进一步扩展计算工作负载。
3. 线程模型(Threading Model)
- Kafka Streams 允许用户配置应用程序实例中用于并行处理的线程数量。
- 每个线程可以独立执行一个或多个流任务及其处理器拓扑。
- 启动更多线程或应用程序实例相当于复制拓扑并处理不同的 Kafka 分区子集,从而实现并行处理。
- 线程之间没有共享状态,因此不需要线程间协调,简化了并行处理。
动态扩展:
- 从 Kafka 2.8 开始,可以动态扩展流线程,类似于扩展 Kafka Streams 客户端。
- 添加或删除流线程时,Kafka Streams 会自动重新分配分区。
- 还可以添加线程以替换故障的流线程,而无需重启客户端。
4. 示例
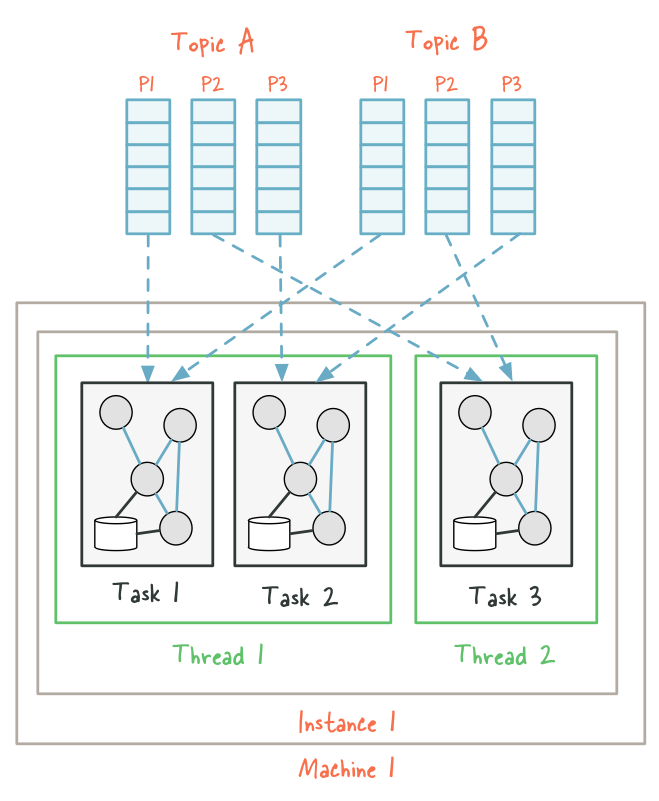
假设一个 Kafka Streams 应用程序从两个主题 A 和 B 消费数据,每个主题有 3 个分区。如果在一台机器上启动应用程序并配置 2 个线程,Kafka Streams 会创建 3 个流任务(因为输入主题的最大分区数为 3),并将 6 个输入分区均匀分配给这些任务。最终,这 3 个任务会均匀分配到 2 个线程中:
- 第一个线程运行 2 个任务(处理 4 个分区)。
- 第二个线程运行 1 个任务(处理 2 个分区)。
如果扩展应用程序并在另一台机器上启动一个单线程实例,Kafka Streams 会重新分配分区,将部分任务(及其本地状态存储)迁移到新线程。
总结
- 流分区与流任务:
- 流分区对应 Kafka 主题分区,流任务是并行处理的基本单位。
- 应用程序的最大并行度受限于输入主题的分区数量。
- 子拓扑:
- 单个拓扑可以分解为多个子拓扑,每个任务只处理一个子拓扑。
- 子拓扑通过 Kafka 主题交换数据,不共享状态存储。
- 线程模型:
- 每个线程可以独立执行一个或多个流任务。
- 线程之间没有共享状态,简化了并行处理。
- 支持动态扩展流线程,无需重启应用程序。
- 扩展性:
- 通过增加应用程序实例或线程,可以扩展处理能力。
- 分区和任务的重新分配由 Kafka Streams 自动处理,确保负载均衡。
核心价值:
- Kafka Streams 的并行模型基于 Kafka 的分区机制,提供了高扩展性和弹性。
- 通过流任务和子拓扑的设计,Kafka Streams 能够高效地并行处理数据流。
- 动态扩展和自动负载均衡使得 Kafka Streams 非常适合大规模流处理场景。
State
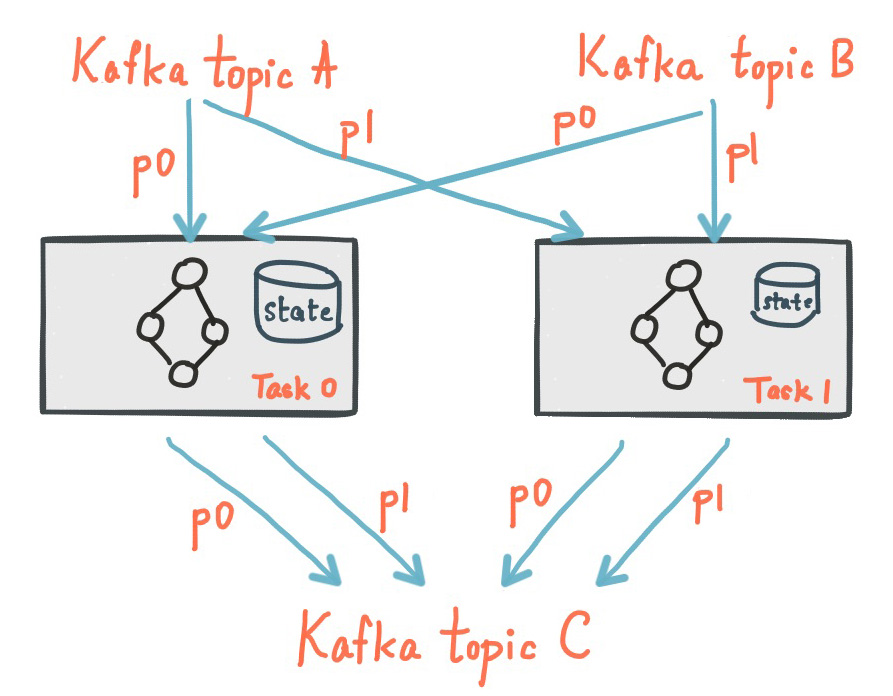
状态(State)
Kafka Streams 提供了 状态存储(State Stores),用于流处理应用程序存储和查询数据。这是实现有状态操作(如聚合、窗口化等)的重要能力。以下是 Kafka Streams 状态管理的详细说明和总结。
1. 状态存储(State Stores)
- 定义:
- 状态存储是 Kafka Streams 中用于存储和查询数据的本地存储。
- 每个流任务可以嵌入一个或多个本地状态存储,用于存储处理所需的数据。
- 状态存储可以是 RocksDB 数据库、内存哈希表或其他数据结构。
- 自动管理:
- 当调用有状态操作符(如
count()、aggregate())或对流进行窗口化时,Kafka Streams DSL 会自动创建和管理状态存储。 - 容错与恢复:
- Kafka Streams 为本地状态存储提供了容错和自动恢复机制,确保在故障情况下数据不会丢失。
2. 状态存储的类型
- 本地状态存储(Local State Stores):
- 每个流任务维护自己的本地状态存储。
- 状态存储可以是:
- RocksDB:基于磁盘的高性能键值存储,适合大规模状态数据。
- 内存哈希表:适合小规模状态数据,访问速度快。
- 其他数据结构:根据需求选择合适的数据结构。
- 全局状态存储(Global State Stores):
- 跨多个任务或实例共享的状态存储。
- 通常用于需要全局访问的状态数据。
3. 状态存储的分布
- Kafka Streams 应用程序通常运行在多个实例上,状态数据分布在所有实例的本地状态存储中。
- 状态存储的分区方式与 Kafka 主题的分区方式一致,确保数据局部性和高效处理。
4. 状态存储的访问
- 本地访问:
- 通过 Kafka Streams API,可以在应用程序实例级别访问本地状态存储。
- 例如,在流任务中直接查询或更新状态存储。
- 全局访问:
- 通过 交互式查询(Interactive Queries),可以在逻辑应用程序级别访问整个状态存储。
- 例如,查询所有实例的状态数据以获取全局聚合结果。
5. 状态存储的应用场景
- 有状态操作:
- 如计数(
count())、聚合(aggregate())、窗口化(window())等操作需要依赖状态存储。 - 交互式查询:
- 允许外部系统或用户实时查询流处理应用程序的状态。
- 容错与恢复:
- 状态存储的容错机制确保在实例故障时能够自动恢复状态数据。
总结
- 状态存储的作用:
- 用于存储和查询流处理应用程序的状态数据,支持有状态操作。
- 类型与实现:
- 本地状态存储(如 RocksDB、内存哈希表)和全局状态存储。
- Kafka Streams 自动管理状态存储的创建和维护。
- 分布与访问:
- 状态数据分布在多个实例的本地状态存储中。
- 支持本地访问和全局访问(通过交互式查询)。
- 容错与恢复:
- Kafka Streams 提供状态存储的容错和自动恢复机制,确保数据可靠性。
- 应用场景:
- 有状态操作(如聚合、窗口化)。
- 交互式查询,支持实时状态访问。
- 容错与恢复,确保高可用性。
核心价值:
- Kafka Streams 的状态存储为流处理应用程序提供了强大的状态管理能力。
- 通过本地和全局状态存储,支持高效的有状态操作和实时查询。
- 容错和自动恢复机制确保了状态数据的高可靠性和高可用性。
Memory Management
内存管理(Memory Management)
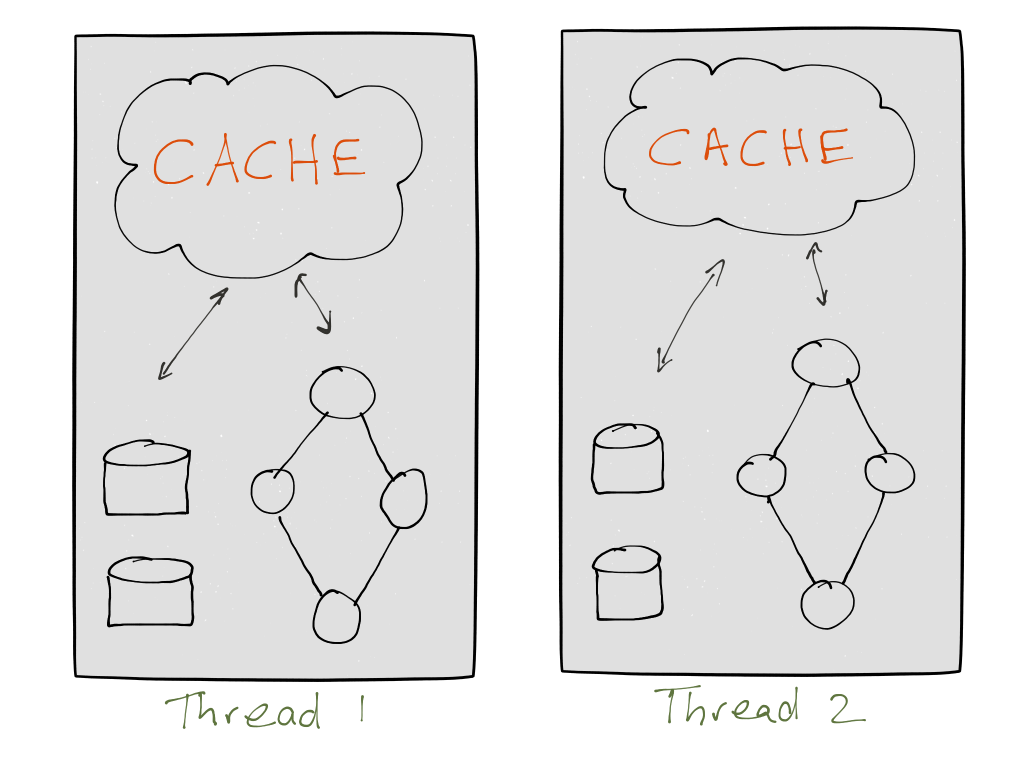
Kafka Streams 提供了灵活的内存管理机制,允许用户为处理拓扑实例指定总内存(RAM)大小。这些内存用于内部缓存和记录压缩,以提高处理效率并减少对状态存储和下游节点的写入压力。以下是 Kafka Streams 内存管理的详细说明和总结。
1. 记录缓存(Record Caches)
- 定义:
- Kafka Streams 使用内存缓存来优化记录的读取和写入操作。
- 缓存内存大小由用户配置,并在拓扑实例的所有线程之间平均分配。
- 缓存的功能:
- 读取缓存:
- 加速从状态存储中读取数据。
- 写回缓存(Write-back Buffer):
- 作为状态存储的写回缓冲区,支持批量写入,减少对状态存储的请求次数。
- 对具有相同键的记录进行压缩,减少写入量。
- 减少下游记录:
- 通过缓存压缩,减少发送到下游处理器节点的记录数量。
2. 缓存的配置与权衡
- 缓存大小的配置:
- 用户可以为拓扑实例指定总缓存大小,缓存内存在所有线程之间共享。
- 每个线程维护一个内存池,供其任务的处理节点使用。
- 缓存大小的权衡:
- 较小的缓存大小:
- 下游更新频率较高,更新间隔较短。
- 适合需要低延迟的场景。
- 较大的缓存大小:
- 下游更新频率较低,更新间隔较长。
- 减少网络 I/O(如 Kafka)和本地磁盘 I/O(如 RocksDB 状态存储)。
- 适合需要高吞吐量的场景。
- 缓存的影响:
- 无论缓存大小如何(包括禁用缓存),最终的计算结果都是相同的。
- 缓存是否启用是安全的,不会影响结果的正确性。
3. 缓存的行为
- 缓存更新的不确定性:
- 无法预测缓存何时或如何压缩记录,因为这取决于多种因素:
- 缓存大小。
- 处理数据的特性。
- 配置参数(如
commit.interval.ms)。
4. 缓存的实现差异
- DSL 与 Processor API:
- 在 DSL 和 Processor API 中,缓存的实现略有不同。
- DSL 自动管理缓存,而 Processor API 提供了更细粒度的控制。
总结
- 缓存的作用:
- 加速状态存储的读取。
- 作为写回缓冲区,减少对状态存储和下游节点的写入压力。
- 通过压缩记录,减少网络和磁盘 I/O。
- 缓存的配置:
- 用户可以为拓扑实例指定总缓存大小,缓存内存在所有线程之间共享。
- 缓存大小影响下游更新的频率和间隔。
- 缓存的权衡:
- 较小的缓存:低延迟,高更新频率。
- 较大的缓存:高吞吐量,低更新频率。
- 缓存的安全性:
- 无论缓存大小如何,最终计算结果一致。
- 启用或禁用缓存是安全的。
- 缓存的行为:
- 缓存更新的时间和方式取决于缓存大小、数据特性和配置参数。
核心价值:
- Kafka Streams 的内存管理机制通过记录缓存优化了读取和写入性能。
- 用户可以根据业务需求灵活配置缓存大小,在延迟和吞吐量之间找到最佳平衡。
- 缓存的使用是透明的,不会影响计算结果的正确性。
Fault Tolerance
容错机制(Fault Tolerance)
Kafka Streams 基于 Kafka 原生的容错能力构建,提供了强大的故障恢复机制,确保在应用程序或机器故障时能够透明地恢复处理。以下是 Kafka Streams 容错机制的详细说明和总结。
1. Kafka 的容错能力
- 分区高可用性:
- Kafka 分区具有高可用性和副本机制,确保数据持久化后即使应用程序故障也能重新处理。
- 任务故障恢复:
- Kafka Streams 任务利用 Kafka 消费者客户端的容错能力处理故障。
- 如果任务运行的机器发生故障,Kafka Streams 会自动在剩余的应用程序实例中重新启动任务。
2. 本地状态存储的容错
- 状态存储的持久化:
- 对于每个状态存储,Kafka Streams 维护一个复制的 changelog Kafka 主题,用于跟踪状态更新。
- Changelog 主题也是分区的,每个本地状态存储实例(以及访问该存储的任务)都有自己专用的 changelog 分区。
- 日志压缩:
- Changelog 主题启用了日志压缩,可以安全地清除旧数据,防止主题无限增长。
- 状态恢复:
- 如果任务在故障机器上运行并在另一台机器上重新启动,Kafka Streams 会通过重放相应的 changelog 主题来恢复状态存储的内容,确保状态与故障前一致。
- 故障处理对最终用户完全透明。
3. 优化任务恢复
- 备用副本(Standby Replicas):
- 为了最小化任务恢复时间,可以配置应用程序的本地状态备用副本。
- 备用副本是状态的完全复制副本,当任务迁移发生时,Kafka Streams 会将任务分配给已存在备用副本的应用程序实例。
- 从 Kafka 2.6 开始,Kafka Streams 保证任务会分配给具有最新本地状态副本的实例(如果存在)。
- 配置参数:
- 通过
num.standby.replicas配置备用副本的数量。 - 备用任务增加了在故障情况下存在最新副本的可能性。
4. 机架感知(Rack Awareness)
- 备用副本的机架感知:
- 可以配置备用副本的机架感知,Kafka Streams 会尝试将备用任务分配到与活动任务不同的机架上。
- 当活动任务的机架发生故障时,可以更快地恢复。
- 通过
rack.aware.assignment.tags配置机架感知。 - 客户端机架配置:
- 使用
client.rack配置客户端的机架。 - 如果 Kafka 代理也配置了
broker.rack,则可以通过rack.aware.assignment.strategy启用机架感知任务分配,减少跨机架流量。 - 优先级:
- 如果同时配置了
rack.aware.assignment.tags和client.rack,则rack.aware.assignment.tags优先用于备用任务的机架分配。
总结
- Kafka 的容错能力:
- Kafka 分区的高可用性和副本机制为 Kafka Streams 提供了基础容错能力。
- 任务故障时,Kafka Streams 会自动在剩余实例中重新启动任务。
- 本地状态存储的容错:
- 通过 changelog 主题跟踪状态更新,确保状态存储的持久化和恢复。
- 日志压缩防止 changelog 主题无限增长。
- 优化任务恢复:
- 配置备用副本(
num.standby.replicas)以最小化任务恢复时间。 - 备用任务提高了故障恢复的效率和可靠性。
- 机架感知:
- 通过机架感知配置,将备用任务分配到不同的机架,提高故障恢复速度。
- 使用
rack.aware.assignment.tags和client.rack配置机架感知。
核心价值:
- Kafka Streams 提供了强大的容错机制,确保在应用程序或机器故障时能够透明地恢复处理。
- 通过备用副本和机架感知优化任务恢复,最大限度地减少故障对系统的影响。
- 容错机制的设计使得 Kafka Streams 非常适合高可用性和高可靠性的流处理场景。
Local State Consistence
本地状态一致性(Local State Consistency)
Kafka Streams 通过将状态更新写入本地状态存储和内部的 changelog 主题来维护本地状态的一致性。以下是 Kafka Streams 在 精确一次语义(EOS) 和 至少一次语义(ALOS) 下如何确保本地状态一致性的详细说明和总结。
1. 本地状态与 Changelog 主题的同步
- 状态更新:
- 当状态更新时,Kafka Streams 会同时将更新写入本地状态存储和内部的 changelog 主题。
- Changelog 主题用于持久化状态更新,确保在故障恢复时能够重建状态。
- 同步机制:
- Kafka Streams 通过维护一个客户端本地的 检查点文件(checkpoint file) 来记录状态存储与 changelog 主题的同步点。
- 检查点文件仅存储元数据,用于标识状态存储与 changelog 主题的一致性。
2. 精确一次语义(EOS)下的状态一致性
- 状态不一致的处理:
- 如果启用 EOS 并且本地状态与 changelog 主题不一致,Kafka Streams 会删除状态存储并从 changelog 主题重建状态。
- 这种情况通常发生在 Kafka Streams 崩溃或 Kafka 代理无法接受写入时。
- 状态重建:
- 状态重建是一个昂贵的过程,但很少发生。
- 在任务重新平衡时(例如任务迁移到新节点),也可能需要从 changelog 主题重建状态存储。
- 检查点文件的作用:
- 检查点文件用于记录状态存储与 changelog 主题的同步点。
- 如果 Kafka Streams 检测到状态不一致,会丢弃整个状态存储并从 changelog 主题重建。
3. 至少一次语义(ALOS)下的状态一致性
- “脏”写入:
- 在非 EOS 情况下,Kafka Streams 可能会存在“脏”写入(即部分写入未完全同步)。
- 由于至少一次语义不保证状态一致性,因此不会尝试重建状态。
- 状态同步机制:
- Kafka Streams 确保在提交偏移量和更新检查点文件之前,状态存储已刷新到磁盘,并且 changelog 主题已写入 Kafka。
- 如果在两次提交之间发生错误,Kafka Streams 会重用现有的状态存储和 changelog 主题。
- Changelog 重放:
- 在恢复数据处理之前,Kafka Streams 会重放 changelog 主题的尾部(从检查点偏移量到末尾)。
- 这确保所有写入 changelog 主题的更新也反映在状态存储中,保持两者同步。
总结
- 本地状态与 Changelog 主题的同步:
- 状态更新同时写入本地状态存储和 changelog 主题。
- 检查点文件用于记录状态存储与 changelog 主题的同步点。
- 精确一次语义(EOS):
- 如果状态不一致,Kafka Streams 会删除状态存储并从 changelog 主题重建。
- 状态重建是一个昂贵但罕见的过程。
- 至少一次语义(ALOS):
- 可能存在“脏”写入,不尝试重建状态。
- 通过重放 changelog 主题的尾部,确保状态存储与 changelog 主题同步。
核心价值:
- Kafka Streams 通过本地状态存储和 changelog 主题的同步机制,确保了状态的一致性。
- 在 EOS 下,通过状态重建机制保证了精确一次语义。
- 在 ALOS 下,通过重放 changelog 主题的尾部,确保状态存储与 changelog 主题的一致性。
Flow Control with Timestamps
基于时间戳的流控制(Flow Control with Timestamps)
Kafka Streams 通过数据记录的时间戳来调节流的进度,并尝试在时间上同步所有源流。以下是 Kafka Streams 如何利用时间戳进行流控制的详细说明和总结。
1. 时间戳的作用
- 事件时间处理语义:
- Kafka Streams 默认提供事件时间处理语义,确保应用程序基于记录的实际发生时间进行处理。
- 这对于处理多个流(即 Kafka 主题)且包含大量历史数据的应用程序尤为重要。
- 历史数据重处理:
- 当应用程序的业务逻辑发生重大变化(例如修复分析算法中的错误)时,用户可能需要重新处理过去的数据。
- 如果没有适当的流控制,跨主题分区的数据处理可能会不同步,导致错误的结果。
2. 流控制的实现
- 记录时间戳:
- 每个数据记录在 Kafka Streams 中都与一个时间戳相关联。
- 流任务根据其流记录缓冲区中记录的时间戳,确定下一个要处理的分区。
- 分区处理顺序:
- Kafka Streams 不会在单个流内重新排序记录,因为重新排序会破坏 Kafka 的交付语义,并在故障恢复时增加复杂性。
- 流控制是尽力而为的(best-effort),因为无法严格按记录时间戳强制执行跨流的执行顺序。
3. 流控制的挑战
- 严格执行顺序的限制:
- 要严格按时间戳执行顺序,必须等待系统从所有流中接收到所有记录(在实践中可能不可行)。
- 或者,需要注入额外的时间戳边界信息或启发式估计(如 MillWheel 的水印机制)。
总结
- 时间戳的作用:
- Kafka Streams 使用记录的时间戳来调节流的进度,确保事件时间处理语义。
- 对于处理多个流和大量历史数据的应用程序尤为重要。
- 流控制的实现:
- 流任务根据记录时间戳确定下一个要处理的分区。
- Kafka Streams 不会在单个流内重新排序记录,以保持 Kafka 的交付语义。
- 流控制的挑战:
- 严格按时间戳执行顺序需要等待所有记录或注入额外信息,这在实践中可能不可行。
核心价值:
- Kafka Streams 通过时间戳实现了基于事件时间的流控制,确保应用程序能够正确处理历史数据。
- 尽管流控制是尽力而为的,但它为处理多个流和大量数据提供了有效的时间同步机制。
Backpressure
背压机制(Backpressure)
Kafka Streams 不需要使用背压机制,因为它通过深度优先处理策略和 Kafka 的拉取模型实现了自然的流量控制。以下是 Kafka Streams 如何处理数据流以避免背压问题的详细说明和总结。
1. 深度优先处理策略
处理方式:
Kafka Streams 采用深度优先处理策略,每条从 Kafka 消费的记录会完整地通过整个处理器(子)拓扑进行处理,并可能写回 Kafka,然后再处理下一条记录。
这种策略确保了两条连接的流处理器之间不会在内存中缓冲大量记录。
优势:
避免了内存中记录积压的问题,减少了内存压力。
每条记录的处理是独立的,确保系统能够高效地处理数据流。
2. Kafka 的拉取模型
消费者控制:
Kafka Streams 底层使用 Kafka 的消费者客户端,采用基于拉取的消息模型。
下游处理器可以控制读取数据记录的速率,从而自然地实现流量控制。
优势:
拉取模型使得 Kafka Streams 能够根据下游处理能力动态调整数据消费速度,避免了数据积压。
3. 多子拓扑的处理
独立处理:
如果处理器拓扑包含多个独立的子拓扑,这些子拓扑会独立处理数据。
子拓扑之间的数据交换通过 Kafka 主题进行,而不是直接交换数据。
示例:stream1.to("my-topic"); stream2 = builder.stream("my-topic");
在上述示例中,数据通过 Kafka 主题 my-topic 在子拓扑之间交换。
优势:
由于数据交换通过 Kafka 进行,子拓扑之间没有直接的数据依赖,因此不需要背压机制。
总结
深度优先处理策略:
Kafka Streams 采用深度优先处理策略,确保每条记录完整通过处理器拓扑后再处理下一条记录。
避免了内存中记录积压的问题。
Kafka 的拉取模型:
Kafka Streams 利用 Kafka 的拉取模型,下游处理器可以控制数据消费速率,实现自然的流量控制。
多子拓扑的处理:
子拓扑之间通过 Kafka 主题交换数据,没有直接的数据依赖,因此不需要背压机制。
核心价值:
Kafka Streams 通过深度优先处理策略和 Kafka 的拉取模型,避免了背压问题。
这种设计使得 Kafka Streams 能够高效处理数据流,同时减少内存压力和系统复杂性。